
前面我们讲完了 Token,它是大语言模型处理文字时使用的基本单位。
那么接下来问题就来了:一个模型在回答问题的时候,到底能够同时带着多少内容?
这个问题看起来有点抽象,但大家平时应该都遇到过。为什么和 AI 聊着聊着,它突然就像“失忆”了一样,前面说过的话开始记不清了?
但有些 AI 又很奇怪,你明明都重新开了一个聊天窗口,什么资料都没有发,它却还知道你的名字、职业和一些使用习惯。
所以 AI 到底是记得,还是不记得?
这篇其实只需要弄清楚三件事:
- Context 是什么:模型生成这一次回答时,实际能够参考的信息。
- 为什么聊久了会忘:Context Window 有容量,不可能无限装下所有内容。
- 为什么换个窗口还认识你:有些产品会通过 Memory 保存或找回过去的信息,再把它重新交给模型。
Context 到底是什么?
Context 直接翻译成中文,就是“上下文”。
它的意思其实很简单:模型生成这一次回答时,实际收到并且可以参考的信息,就是当前的 Context。
比如你现在问的问题、前面被带入的对话、上传文件中实际读取的内容、系统交给它的要求,以及产品重新调出的记忆,都可能成为当前 Context 的一部分。
这里有一个很容易弄混的地方:Context 并不是单纯等于我们眼睛看到的聊天页面。
有些历史消息还在页面上,你往上翻也能看见,但产品这一次不一定会把它们原封不动地全部交给模型。反过来,系统要求和被调出的记忆可能没有直接显示在聊天页面里,却依然会影响回答。
所以真正要看的不是“页面上还留着什么”,而是“模型这一次实际拿到了什么”。
另外,还有一个经常和 Context 放在一起出现的概念,叫作 Context Window,也就是“上下文窗口”。
这两个词的区别是:Context 是模型这一次实际拿到的信息,Context Window 则是模型一次最多能够容纳多少上下文。
所以你也可以把 Context Window 直接理解成模型的“最大上下文容量”。一个说的是这次实际装进来了多少内容,另一个说的是最多能够装下多少内容。
只需要知道一点:Context Window 再大,也不是无限的,随着聊天越来越长,当前 Context 会不断接近它的容量上限。那装不下的内容会怎么样?这就正好接到了下面这个问题。
为什么一个窗口聊久了,AI 还是会忘?
如果非要打个比方,Context 有点像 AI 的“短期工作记忆”。只要某条信息还在当前 Context 里,模型回答的时候就有机会参考它。
但它和人的记忆并不是一回事。它更像模型这一次干活时,桌面上摆着的一堆材料。桌面再大,能够同时摊开的东西也是有限的。
随着聊天越来越长,新问题、旧对话、AI 的回答和上传的资料会不断往里面放。产品不可能永远把所有历史内容原封不动地带进每一次回答,只能开始做取舍。
大概可以理解成下面这条链路:
新内容不断进入 → 当前 Context 接近 Context Window 的上限 → 旧内容被省略或者压缩 → 一部分细节没有继续带入 → AI 看起来像“忘了”
有时是比较早的内容没有继续提供给模型,有时则是产品先把长对话整理成一份更短的摘要,只保留目标、要求、结论和其他关键信息,只要经过省略或者压缩,就不能保证原来的每一个细节都完整留下。
所以别想着只靠一个聊天窗口一直聊,AI 就会无限地越来越懂你,因为 AI 的脑容量有限,也就是上下文窗口有限
这里还要补一个边界:信息仍然在 Context 里,也不代表模型一定能够准确找到并使用它。内容太多、要求互相冲突,或者某个细节埋得太深,AI 一样可能漏掉或者理解错。
如果当前窗口已经聊得很长,AI 开始混乱,一个比较实用的办法就是先让它整理一次,再换到新窗口继续:
让 AI 整理目标、要求、重要信息和待办 → 自己检查有没有漏掉 → 复制到新窗口 → 继续完成任务
这就相当于我们自己手动压缩了一次上下文。它不能保证什么都不丢,但通常比拖着一个已经很乱的窗口继续聊更稳。
换了窗口,为什么它还认识你?
那么问题又来了:
我明明重新开了一个聊天窗口,之前的 Context 应该已经没有了,为什么有些 AI 还知道我叫什么?
这就涉及另一个词:Memory,也就是 AI 产品里的“记忆”。
Memory 可以先简单理解成:AI 产品用来跨聊天保存、查找并重新利用过去信息的一套机制。
它可能会留下你的名字、职业、兴趣或者写作偏好。有些信息由你主动填写,有些可能从过去的聊天中整理出来,还有些产品能够在需要时重新查找以前的对话。不同产品具体怎么做并不完全一样。
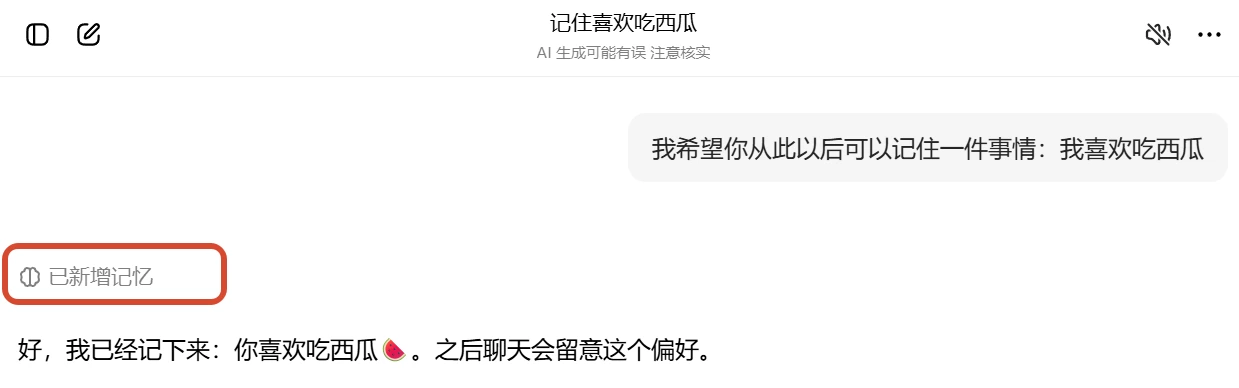
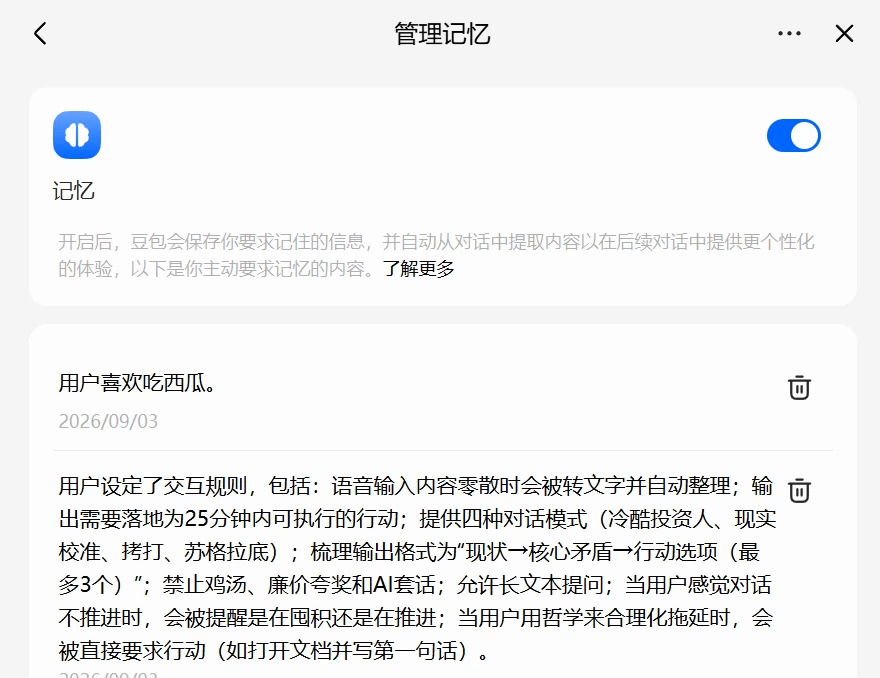
比如有些产品允许你查看和修改已经保存的记忆,也可以直接在对话里告诉它:“记住我以后写文章不要分太多标题。”
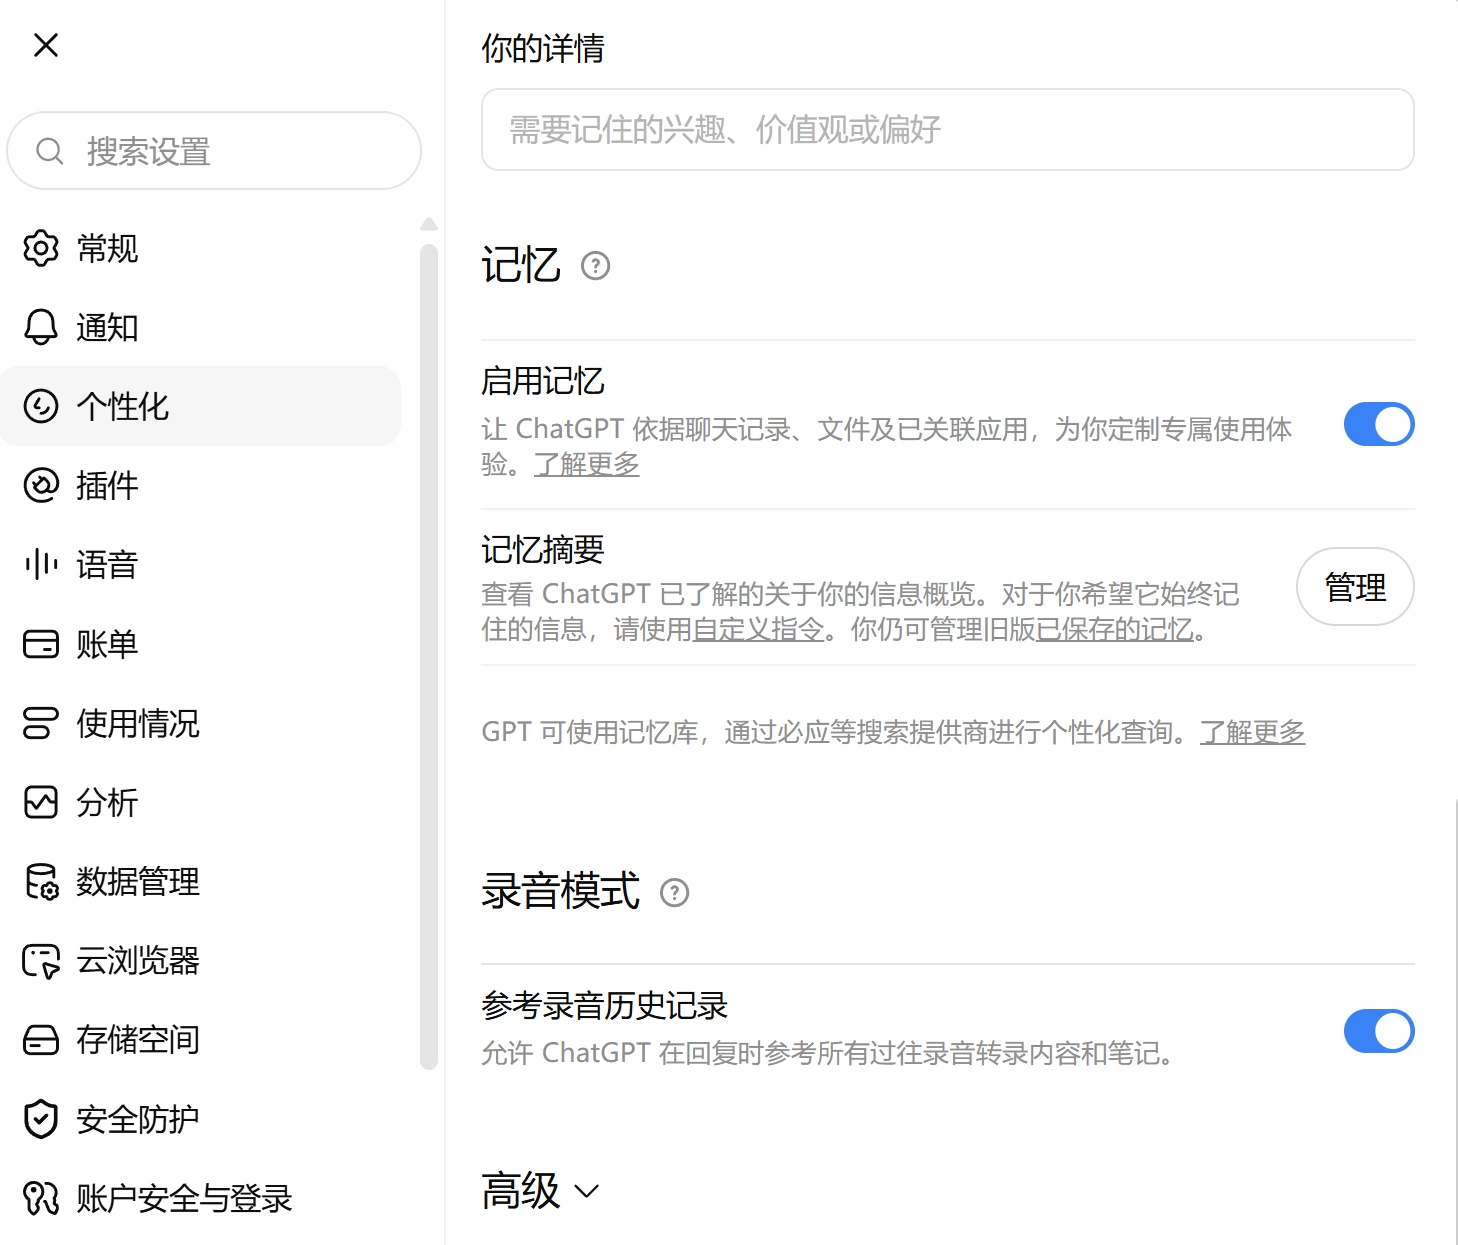
国内的一些 AI 产品也提供了类似功能,例如像豆包,可以让用户主动要求它记住或者忘记某些信息。
但 Memory 并不是把所有聊天记录完整地、永久地塞进模型脑子里。
它通常只会保留或者找回一部分信息,所以可能会漏掉,也可能会记错。最重要的是,Memory 最后仍然要回到 Context,模型才能在这一次回答里使用它。
它们之间的关系可以这样看:
过去的聊天和信息 → 被 Memory 保存或重新找到 → 放进当前 Context → 模型在这一次回答里继续使用
ok 最后我们在总结下
- Context 是 AI 当前能参考的信息:可以把它类比成“短期工作记忆”,但它本质上是这一轮模型能够看到的信息。
- Context Window 是有容量的:信息太多以后,就需要截断、压缩或者按需检索,不可能无限装。
- Memory 负责让过去的信息跨聊天继续发挥作用:需要的时候,产品会把相关记忆重新提供给模型,让它再次成为当前 Context 的一部分。
AI 为什么会忘、为什么换个窗口有时还认识你,基本也就讲明白了。
再往后还会遇到一种情况:外部资料太多,全部塞不进 Context,系统就先从里面找到最相关的内容,再交给模型。
大量外部资料 → 找出当前相关的部分 → 放进 Context → 模型根据这些内容回答,这就是要涉及到 RAG(Retrieval-Augmented Generation 检索增强生成)相关的知识了,这个会在进阶篇讲,这里就不展开了。
咱们下篇要讲到是,一个更加重要,已经开始慢慢融入到我们生活中的:Agent!