
2026 年,网上开始出现一些看起来很魔幻的新闻。
5 月,三名“00 后”创业者回到母校,给近 500 名学弟学妹捐了 20 亿 Token,让他们能够使用一款 AI 外贸工具。?
到了 9 月,杭州人才中心又宣布,将从 9 月 20 日起给 35 家大学生创业园试点发放免费的 Token 卡。现在一些互联网公司甚至会给员工分配 Token 额度。
以及大家不知道有没有在网上刷到过,如果一家公司提供 token 报销,弹幕就肯定会有:“这是什么神仙公司”
以前学校发饭卡、奖学金,单位报销差旅费,现在怎么开始发 Token、报销 Token 了?
甚至有网友评价,感觉 token 就是新一代人要领的鸡蛋。
所以,Token 到底是个什么东西?
它是怎么和钱扯上关系的?
为什么平时感知不到 token?
Token 到底是什么?
如果只记一句话,你可以先把 Token 理解成:AI 处理文字时使用的一种计量单位。
我们平时统计一段文字,会说它有多少个汉字、多少个英文单词。但是大语言模型不是固定按照一个汉字或者一个单词来计算的,它有自己的一套拆分方式。
文字交给模型以后,会先被拆成一个个小片段。这个小片段,就叫 Token。
比如我输入了一句话:
30aitool这个网站真实用
这里面有数字、英文字母和汉字。但在下面这个 Tokenizer,也就是用来展示文字怎样被切分的工具里,它最后被拆成了 7 个 Token。
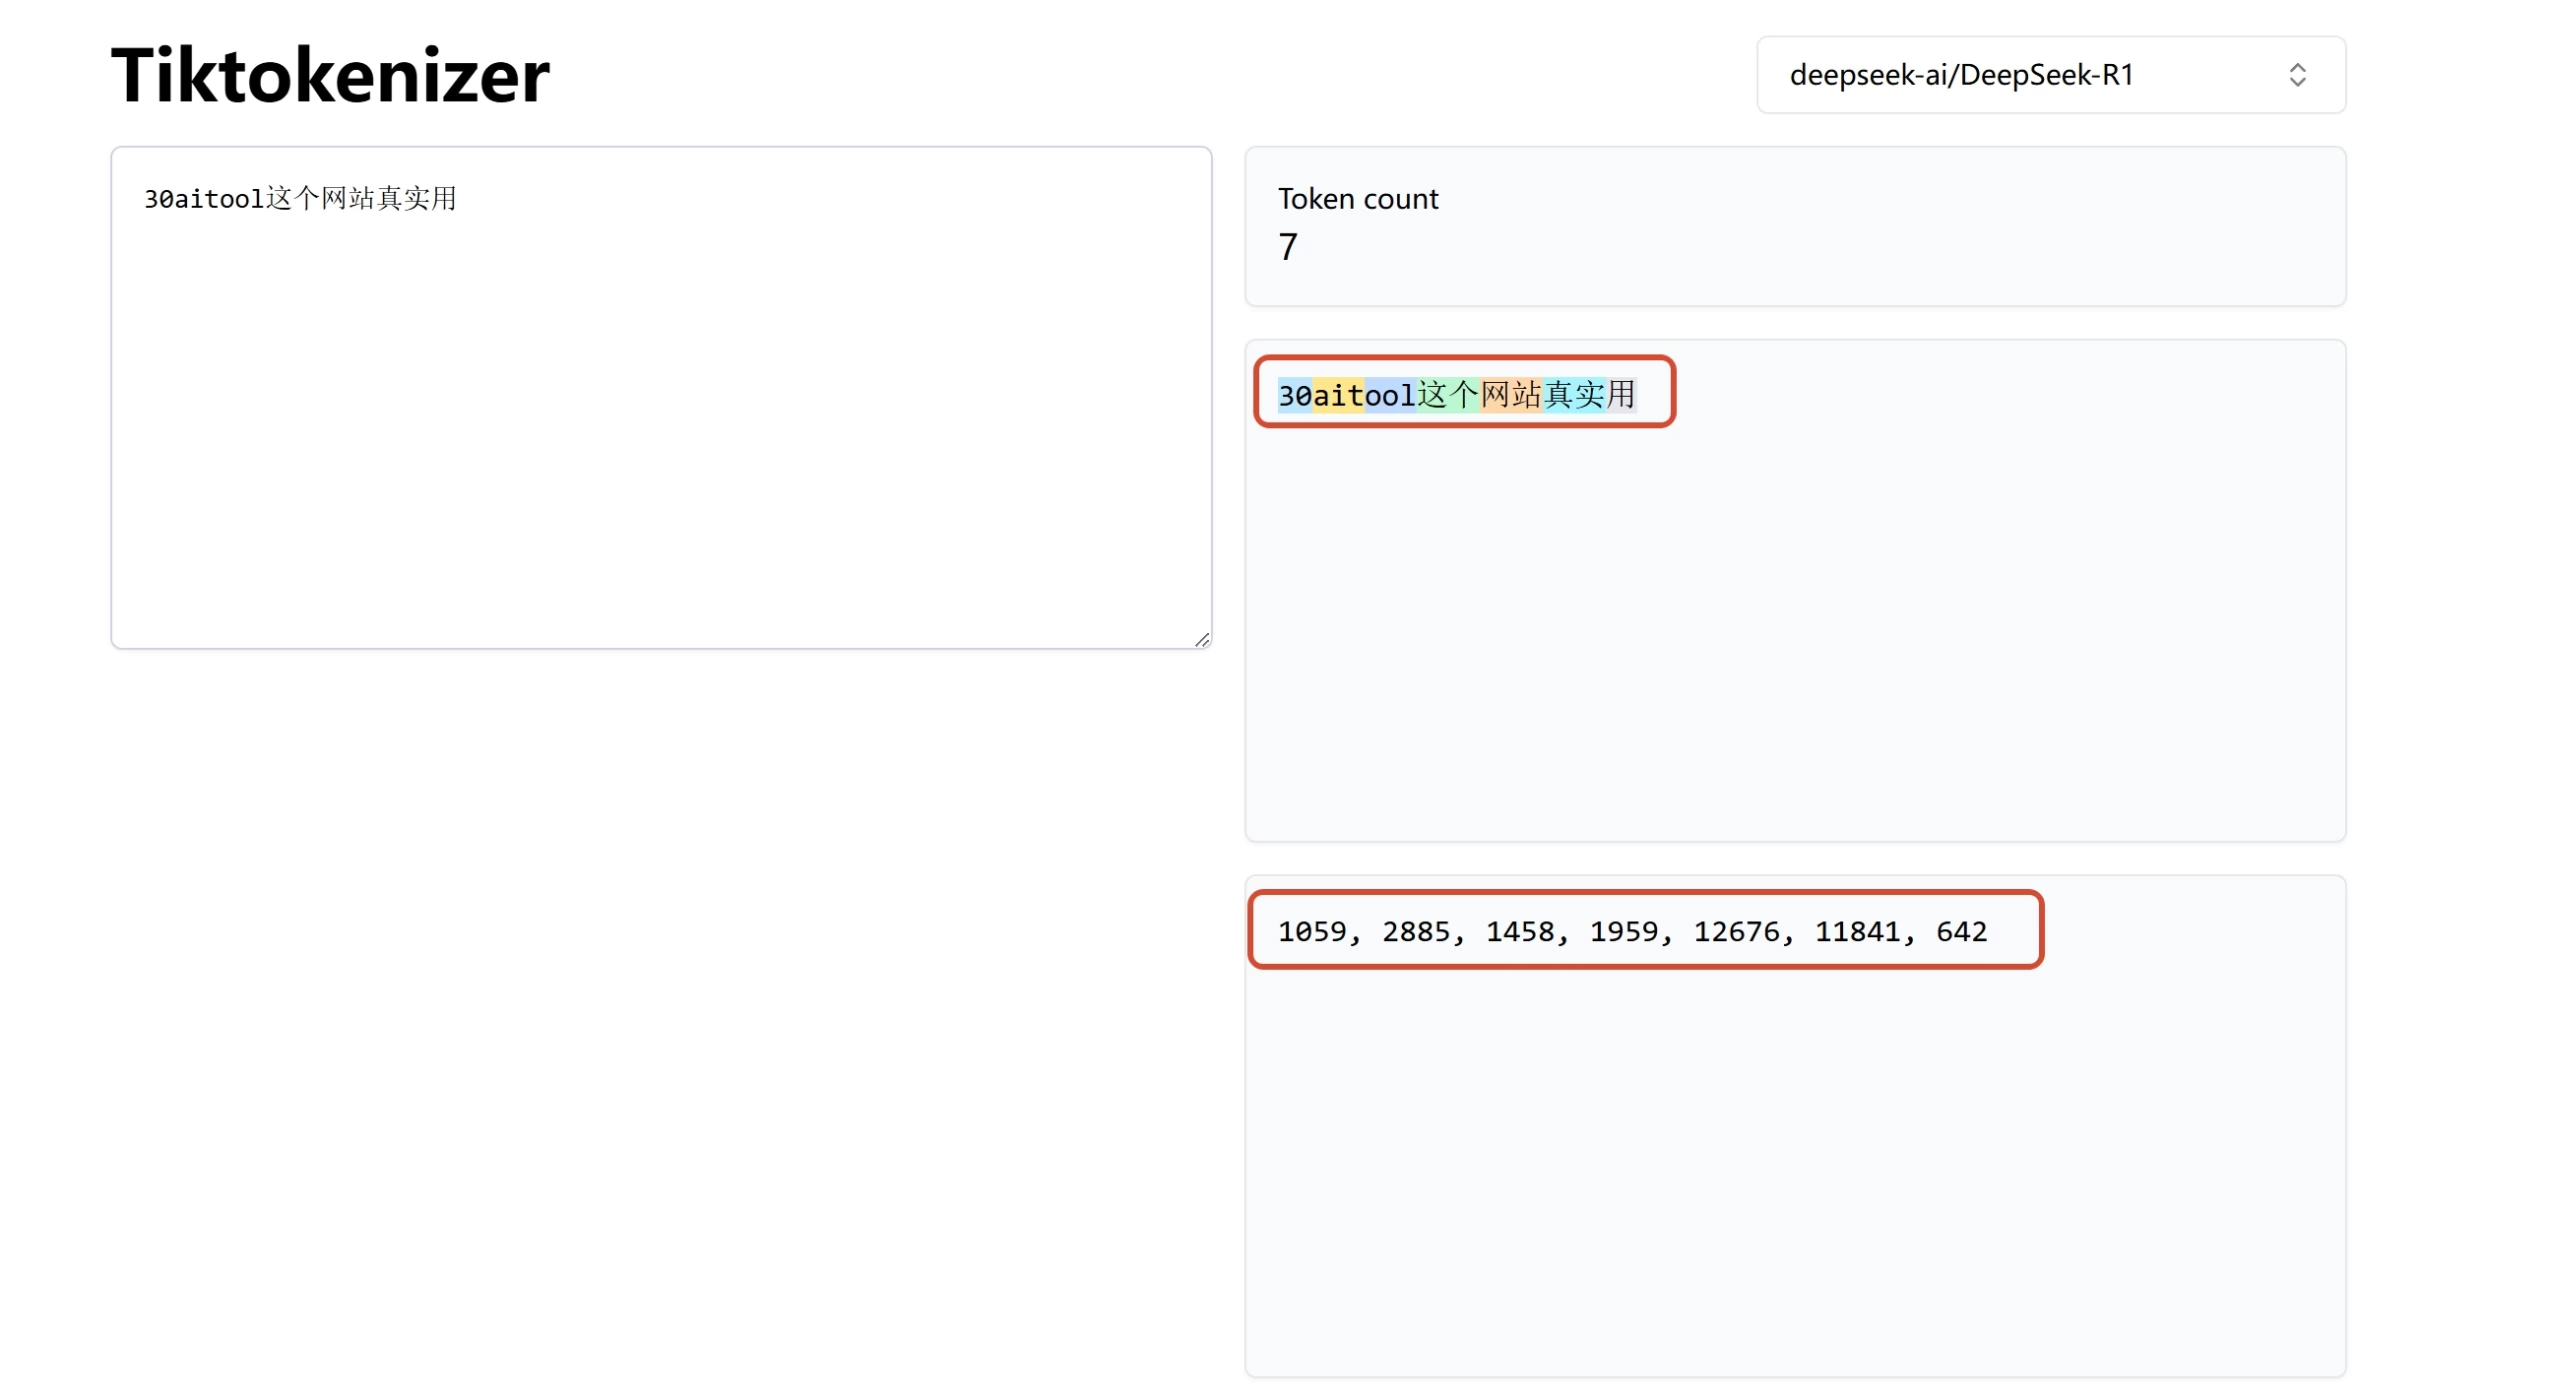
看图里不同颜色的部分,就能大概看出模型是怎么切的,切完以后,每个 Token 还会对应一个数字,模型真正处理的就是这些数字。
一个 Token 不固定等于一个汉字,也不固定等于一个英文单词,有时一个词会被拆成几段,有时几个字符又会被放在同一个 Token 里,换一种语言、换一个模型或者换一种编码方式,最后算出来的数量也可能不一样。
想要更具体到了解token 是如何进行切分,我推荐看下面这个通俗解释老师的视频。
不是我偷懒自己不讲,而是我感觉我不可能写的比通俗易懂老师写的好,为了让大家更好理解就直接引用了。
这个视频是在网上能找到把 Token 讲得最通俗易懂的,那灵魂的配图也很容易让人理解,视频就 5 分钟,大家先去看完再回来继续往下看。
不过,大家只需记得:Token 不是按照我们熟悉的“几个字、几个单词”来处理文字,同一段内容在不同模型、编码和语言下,结果都可能变化即可。
顺便补充一句,2026 年 3 月,咱们国家决定优先推荐把 AI 领域的 Token 中文名叫作“词元”,词元就是咱们国家 token 的官方翻译,但是吧,其实用词元来表述的还是比较少,大家一般都还是叫 token。
Token 怎么变成 AI 的使用量和费用?
现在再回头看开通提到各种关于 token 相关内容,是不是可以理解了
他们送其实就是一笔可以让 AI 继续处理和生成内容的使用额度,因为模型每读取一段内容、生成一段回答,都会产生 Token 用量。
很多模型还会通过 API 提供给其他软件调用。API 这个概念我们后面会专门讲,现在可以先把它理解成:你不是打开 DeepSeek、豆包或者 ChatGPT 的官方聊天页面,而是在另一个软件里直接调用它背后的模型,这时候,厂商就可以按照实际产生的 Token 来计算费用。
这里先认识两个最常见的名字:
输入 Token:也就是你交给模型读取的内容,比如问题、聊天记录、文章和这一轮需要参考的资料。
输出 Token:模型生成出来的内容,也就是它最后写了多少。
截至 2026 年 9 月 5 日,DeepSeek 的 API 价格表就是分别列出输入和输出 Token 的价格,再按照实际用量计算费用。缓存、思考 Token 和高峰低谷价属于更细的计费问题,这一篇先不展开。
我把余华的《许三观卖血记》整本丢给 DeepSeek 进行处理,让它扫描小说内容,估算长度,再做一个简单概括。
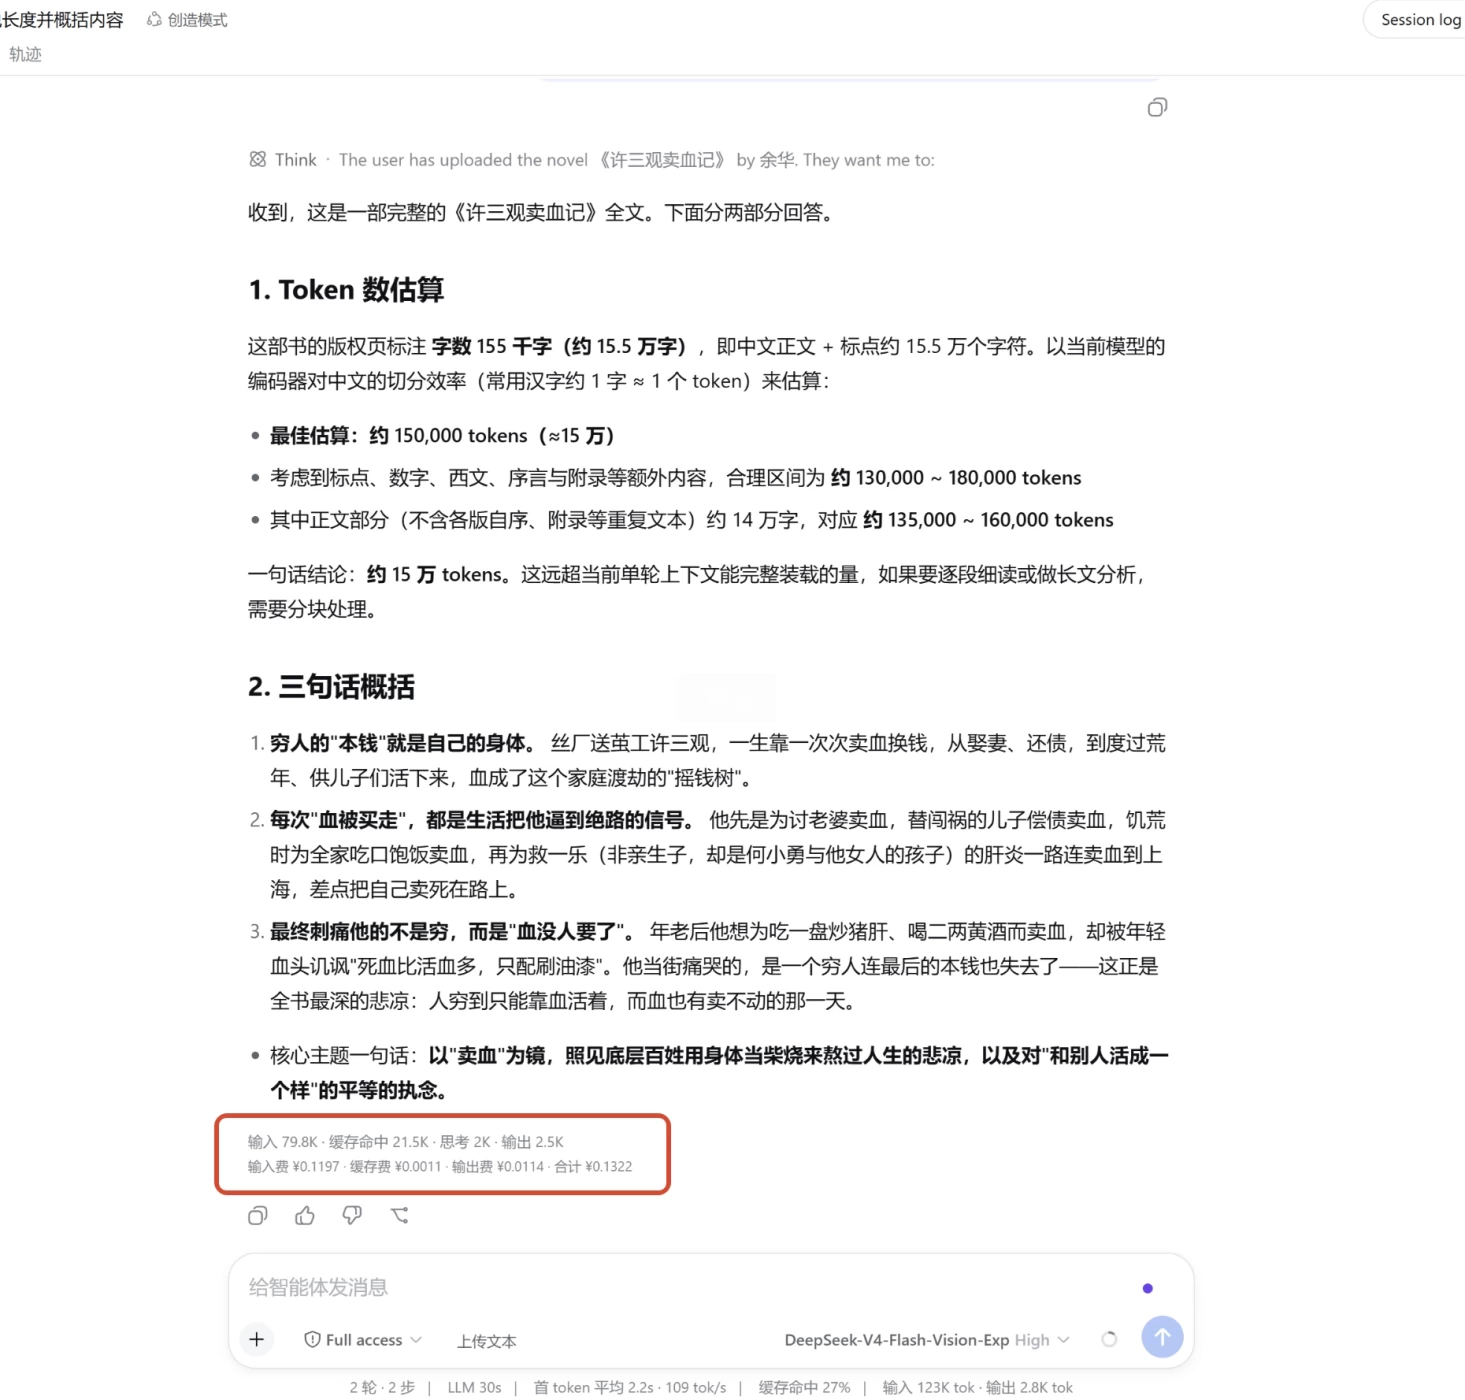
这一次调用里,后台显示了大约 79.8K 输入 Token 和 2.5K 输出 Token,最后的总费用大约是 0.13 元。这里的 K 就是千,79.8K 大约是 7.98 万。页面里还出现了“缓存命中”和“思考”等更细的用量,这篇先不用管。
你不需要记住这些数字,也不要拿它推算“以后读一本书固定就是一毛钱”。模型、任务、缓存和价格一换,结果都会变化。
这张图真正需要看的只有一件事:当 AI 开始读取一整本书并生成结果,后台不会写“读取了十五万字”,而是把这次实际处理的内容换成 Token,再分别记录输入、输出和费用。
一次任务看起来可能很便宜,但如果变成很多 AI 同时、反复工作,数字就会迅速放大。
为什么平时感觉不到?
可能有人会问:我天天用 DeepSeek、豆包和 Kimi,也没见它告诉我用了多少 Token,更没有让我按 Token 付钱啊?
这是因为,我们平时使用的是厂商已经做好的 AI 产品,厂商把模型、界面和收费方式都包装好了,没有直接把这笔账摆到普通用户面前。
这背后其实也是一种很常见的市场策略。
现在各家 AI 产品都希望先让更多人用起来,如果一打开软件,问第一句话就要先充值,再按照 Token 一笔一笔扣钱,大多数普通用户可能直接就走了。
所以我们现在看到的,更多是免费使用、赠送免费额度,或者按月开会员。不同产品的方式不一样,还有些工具会把模型用量换算成自己的积分、点数或者次数。
你看到的可能是“今天还能使用几次”“这个月还剩多少积分”,至于背后调用了什么模型、消耗了多少 Token、成本怎么算,通常已经被产品包在里面了。
所以,如果你只是正常使用 DeepSeek、豆包、Kimi 这些客户端,或者其他已经做好的 AI 工具,确实感知不到 token 的存在
不是它没有消耗 Token,而是这笔账暂时不需要你自己算。
但如果以后开始使用桌面 Agent,自己搭建一个 Agent,或者把不同的模型接进自己的工具里,情况就不一样了。
这时候你会接触到 API,API 可以先简单理解为:让自己的软件或者 Agent,直接去调用某个 AI 模型。
Agent 每读取一次文件、搜索一次资料、调用一次工具、检查一次结果,都可能再次调用模型,也就会不断产生输入和输出 Token,这些 Token 最后就会直接变成你的使用量和费用。
放心这也不难,后面讲到 Agent 和 API 的时候,我们会一步一步说明怎么接入模型、怎么看用量,以及怎么控制成本。
我自己的判断是,随着 Agent 越来越普及,Token 以后大多数人都会接触到,可能不是今天,也不一定需要你手动计算,但你迟早会在额度、积分、API 账单或者 Agent 后台里看到它。
所以这一章不用继续往下讲了,先知道 Token 是 AI 处理文字时使用的计量单位,也会被拿来统计使用量和费用,就够够了
如果想更加了解toekn ,我还推荐看下面的这两个视频。
Token 解决的是:模型按照什么单位来处理文字。
那么,一个模型一次最多能处理多少 Token?为什么聊天太长以后,它又会像忘了前面说过的话?
这就会继续带出下一个概念:Context,也就是上下文。